《人间万象》里提到,我每天的音视频转录量在十几个小时以上。不少朋友问:底下跑的是什么?
2023 年我写过一篇 Whisper 的使用指南(少数派版),算是当时全网介绍得比较全的一篇。前阵子一位高中同学突然找我,说他在搜 Whisper 相关资料时搜到了这篇,点进去才惊喜地发现作者是我——一篇三年前的文章,以这种方式把老同学连上了,挺奇妙的。
三年过去,ASR(自动语音识别,也就是语音转文字)领域变化很大。新模型一茬接一茬,Coding Agent 的能力也让我这种非专业工程师能自己搭整套服务了。但现在的我,已经基本不用 Whisper 了。
音视频里有大量文字世界没有的信息,但只有转成文字,Agent 才读得到。这篇就聊聊,怎么在消费级设备上低成本地给 Agent 装上这对耳朵。还是一贯的思路:你了解个框架就好,具体技术细节留个引子,交给你的 Agent 去读——它结合你的场景讲,肯定比我讲得好。真正值钱的,是实践里踩过的那些坑。
为什么非要在本地跑
在线服务我用得很早。2022 年还写过一篇用飞书妙记提升学习体验的文章,给飞书妙记带去了不少用户;后来也是通义听悟的老用户,云端和本地的模型都折腾过。最后还是落在本地,三个原因。
成本。 在线 ASR 服务大概每小时 0.5 到 1 元。单看不贵,但我每天十几个小时,一个月下来就是几百块。家里的机器反正 24 小时开着,算力不用白不用。
隐私。 音频不出家门。
拒转。 商用服务对有些内容会直接拒绝转录,遇到的时候挺麻烦。而《人间万象》里聊过,音视频最有价值的部分,恰恰是那些没那么"正确"的内容。
需要说明的是,后面的校对环节我用的是云端 LLM API,转录出来的文本还是会出本地。如果对隐私要求更高,校对这一步也完全可以换成本地 LLM。
先说结论:过了及格线,就别卷准确率了
评价一个 ASR 模型,我主要看三件事:
- 资源占用:显存、内存、CPU。在家用场景里,还得算上 24 小时开机的电费。
- 速度:业内常用 RTF(Real Time Factor),即转录耗时除以音频时长,越小越快。RTF 0.1 就是 10 倍实时,一小时音频六分钟转完。下文统一用"几倍实时"来说。
- 质量:转录准确率。
除此之外,还要看支持哪些语种。
我的核心结论是:结合你的场景,在这几者之间取平衡,而不是无脑追求单一指标。
在消费级设备上,开源 ASR 模型的准确率过了一条基线,比如 90% 左右,再往上提,体感就没那么明显了。尤其下游是 AI 总结的时候,更合理的做法是:ASR 打底,配上精准的上下文,让 LLM 再校对一遍。这是我跑下来效果最好、成本最低的方式。
同一个想法,三年后才跑通
有意思的是,这个思路在 2023 年那篇文章里就有雏形了。
当时要转录的是全英文授课、专业名词很多的课程录音。Whisper 支持预先给一段提示词,告诉它音频里可能出现哪些词。我的做法是把课程讲义丢给 Claude 抽关键词,再把关键词当提示词喂给 Whisper,提升专有名词的准确率。我也试过用 GPT-3.5 给转录结果补标点,但它经常自作主张合并文本,时间戳就对不上了;换 GPT-4 又太贵。
三年后,LLM 又便宜又可靠了(像 DeepSeek v4 flash 这类模型,API 价格本身就很低),这件事终于能跑通了。VideoTranscriptAPI 现在的校对流程大致是:
- 拿到音视频的标题、简介、作者这些元信息
- 让 LLM 从中抽出容易转错的词:人名、地名、术语、品牌、缩写、外文词等
- 把这些词写进提示词,对转录稿分段并发校对
- 做一遍质量检查,防止校对把内容改丢了
只要 ASR 有基础准确率,配上 LLM 校对,转录稿的可读性就非常高了。一篇稿子的校对成本也就一两毛钱。
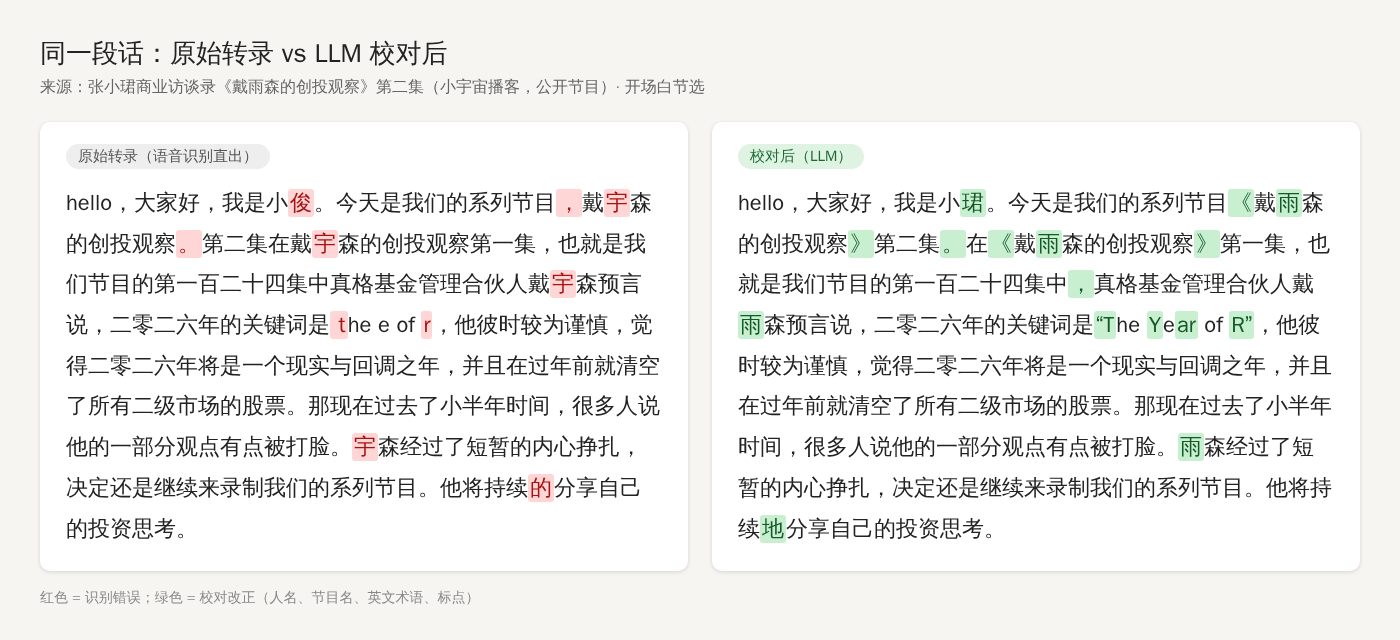
这个结论反过来决定了选型:既然质量可以靠 LLM 兜底,选 ASR 时就应该更关心速度和资源占用。
选型地图
先限定语境:家用消费级设备,以中英文为主。表里的硬件,6800H 指我一台 AMD 核显的 Windows 笔记本,M1 Max 是我的 Mac Studio,RTX 3060 是一张 12G 显存的英伟达显卡。
| 模型 | 擅长 | 硬件 | 速度 | 我怎么用 |
|---|---|---|---|---|
| Whisper | 语种多,出得早 | 最好有独立显卡 | 2023 年 Large 模型:6800H 约 2 倍实时,M1 Max 约 12 倍实时 | 基本不用了 |
| Paraformer-zh | 中文为主,中英混说也能转 | 纯 CPU 即可 | 体感 6800H 上二三十倍实时,M1 Max 上四五十倍 | 追速度,主力 |
| SenseVoice Small | 中、英、粤、日、韩 | CPU / 显卡均可 | — | 平时不用 |
| Qwen3-ASR 1.7B | 准确率天花板,30 种语言 + 22 种中文方言 | 最好有英伟达显卡 | M1 Max 约 8 倍实时;RTX 3060 长音频约 20 倍实时 | 追质量 |
后三个都出自阿里:Paraformer 和 SenseVoice 来自阿里开源的语音工具箱 FunASR,Qwen3-ASR 来自通义千问团队。几句展开:
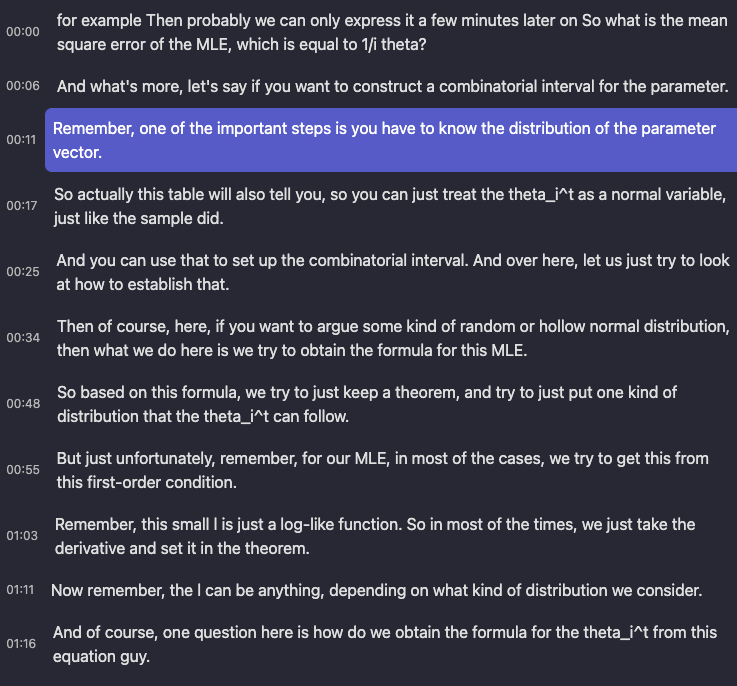
Whisper 2022 年 9 月由 OpenAI 开源,胜在出现得早、支持语种多,所以经常被默认成 ASR 的首选。但如果你的场景主要是中英文,它的准确率已经不如新模型了,资源占用还更高,长音频也容易出现幻觉,不断重复同一句话。当年它让我最惊艳的,是连 theta_i^t 这种符号写法都能转出来。如今除了小语种,我已经没有理由用它了。
Paraformer-zh 是 CapsWriter 里最老的模型,却是我用得最多的。最大的优势是快:普通 CPU 就能跑出几十倍实时,完全不需要显卡,说实话有点恐怖。代价是准确率比 Qwen3-ASR 差一些,但有上下文加 LLM 校对兜底,完全够用。如果你没有显卡,只做中英文转录,我非常推荐它。
SenseVoice Small 语种更多,在上游项目的对比里,准确率和 Paraformer 相当。这里只是介绍一下,我平时不用——我的主要场景是中英文,追求速度用 Paraformer-zh,追求质量用 Qwen3-ASR,两头已经覆盖了。
Qwen3-ASR 1.7B 是目前本地转录质量的天花板。它本质上是让一个语言模型"听"音频再写出文字,能结合上下文猜词,所以专有名词和断句都更准。单任务显存占用大约 3G;如果开了词级时间戳(给每个词标出现时间,做精确对齐的字幕才需要),会到 6G 多。Mac 上也能跑,但有英伟达显卡(CUDA 加速)会快很多。
按场景选,大概是这样:
- 语音输入法:希望原始转录尽可能准,减少二次修改,选 Qwen3-ASR。
- 长音频 + AI 总结:有精准的上下文,Paraformer-zh 就完全够用。
- 需要区分说话人:播客、访谈、会议,看下一节。
- 小语种:这时候 Whisper 还有用武之地。
区分说话人:比想象中难
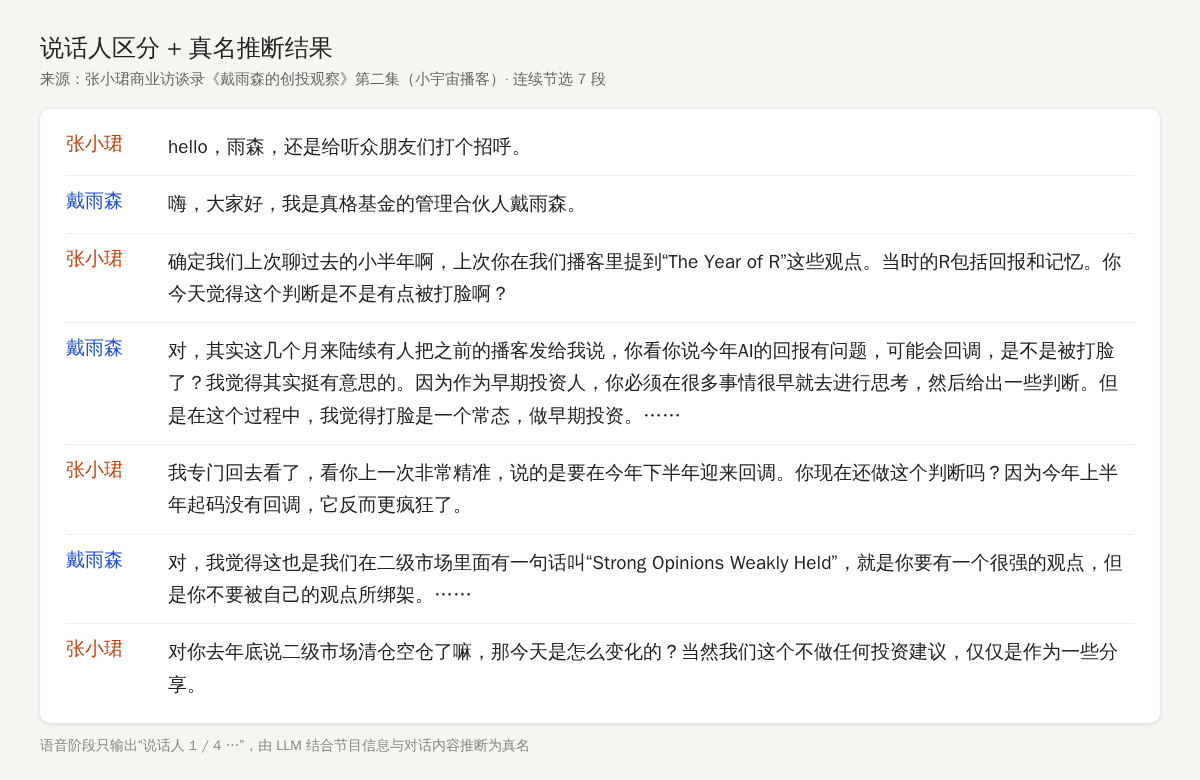
区不区分说话人,看上去只是多一个标签,实际是一整条流水线:
- VAD(语音活动检测):先切出哪些片段有人在说话
- ASR:转成文字
- PUNC:恢复标点
- SPK:判断每段话是谁说的
真正的难点在 SPK。一来一往的访谈还好,但真实场景里对话会重叠,尤其是嘈杂的会议,A 还没说完 B 就插进来,怎么拆?这在业内有个名字,叫"鸡尾酒会问题"。消费级设备算力有限,这类问题基本解决不好。我自己的服务在嘈杂的多人讨论里,识别出的说话人数会差个一到三人。
所以我的态度是:分个大概,体感八九成准,对下游的理解够用了,就差不多得了。
再说一层:在总结类场景里,模型能力足够强的话,其实也未必需要提前区分说话人,它能从上下文推断出谁在说话。只不过如果你能提前把说话人分好,模型就能省下一部分注意力,专注在内容的总结和提炼上,效果会更好。
我是怎么搭的
我手上的设备比较杂,最后搭成了三层:最上面是应用,中间是两个 ASR 服务端,最下面是几台机器。主力是那台 Mac Studio:
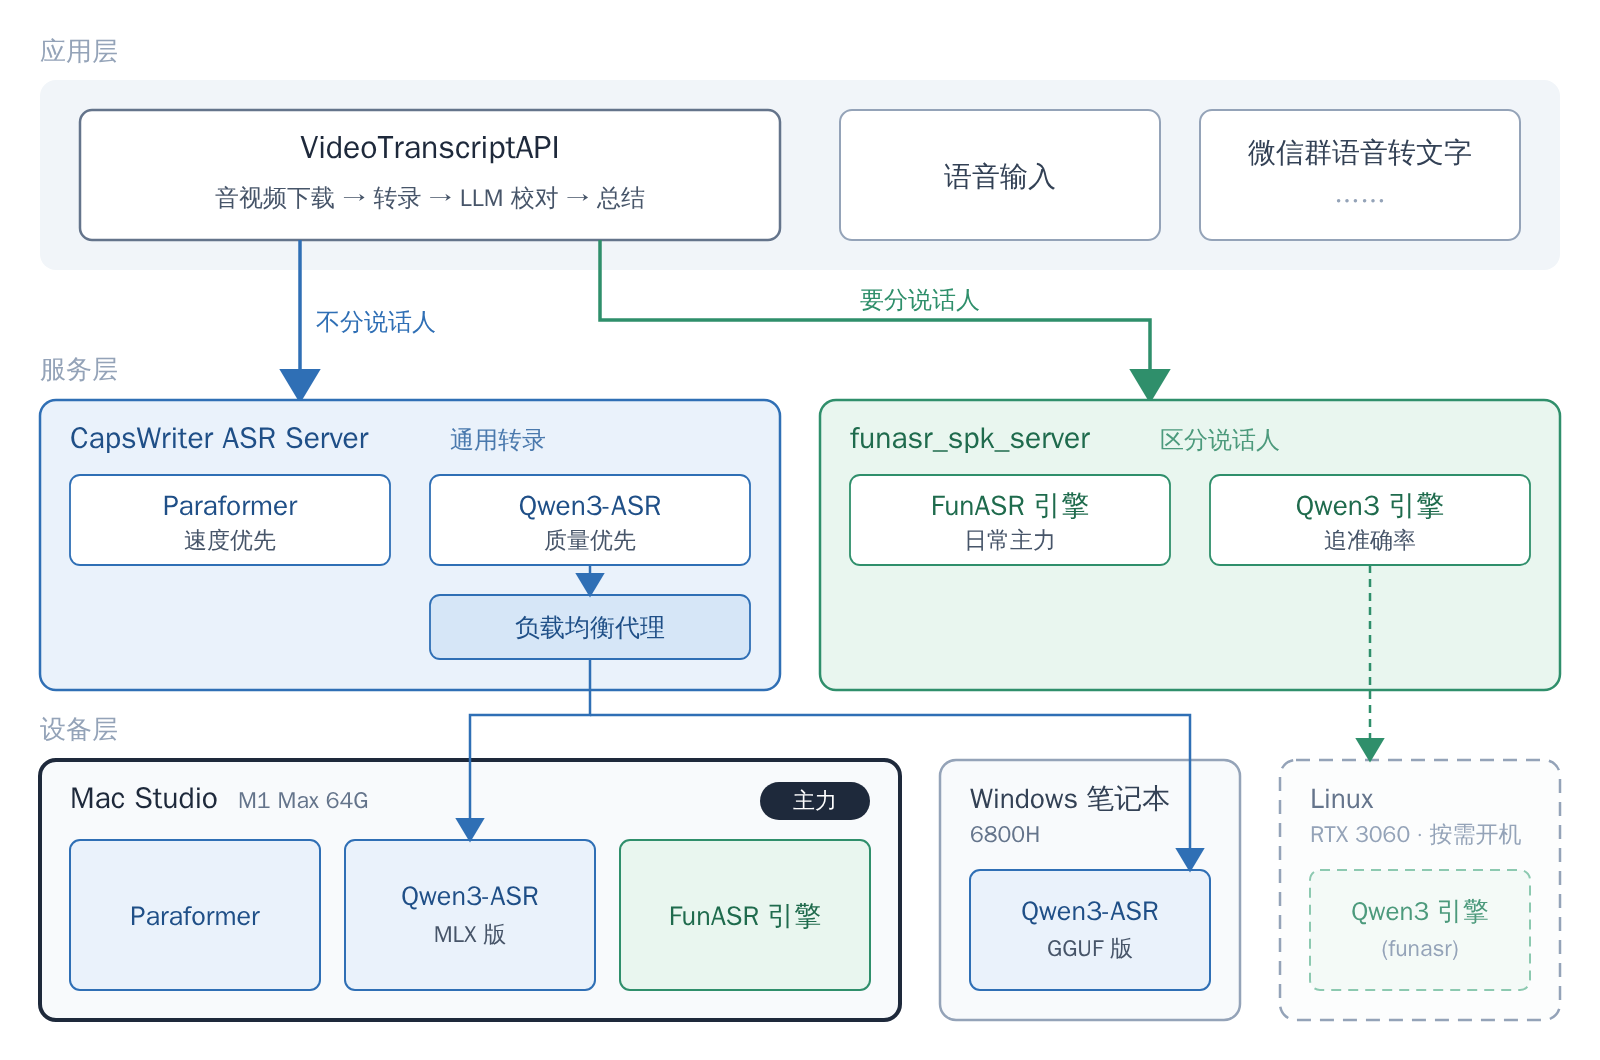
- Mac Studio M1 Max 64G:CapsWriter 跑 Paraformer(速度优先)和 MLX 版 Qwen3-ASR(质量优先),funasr_spk_server 跑 FunASR 引擎(区分说话人)。日常的转录基本都在这台上。
- Windows 6800H 笔记本:CapsWriter 跑 Qwen3-ASR,和 Mac Studio 上的 Qwen3-ASR 一起挂在负载均衡后面,分担追求质量的那部分活。
- Linux + RTX 3060:funasr_spk_server 的 Qwen3 引擎,需要时再开机。
两个 ASR 服务端都以 MIT 许可证开源,下面各用几句话说清楚它们分别是什么。部署细节就别看我讲了,把仓库地址丢给你的 Agent,让它结合你的设备出方案。
CapsWriter ASR Server:通用转录
CapsWriter-Offline 是一个开源的本地语音输入法,作者 HaujetZhao 还写过 QuickCut,就是我三年前那篇文章里推荐过的视频工具。它的服务端内置了好几种 ASR 模型。
2025 年 4 月 VideoTranscriptAPI 刚起步时,以当时 Coding Agent 的能力,我不可能自己从零搭一套 ASR 服务,所以整个项目就直接依赖 CapsWriter 的服务端。
但它原本是为 Windows 设计的,而我的设备 Windows、Mac、Linux 都有。所以今年 5 月我把服务端单独拆出来,改造成了 CapsWriter ASR Server:
- 适配 Windows、macOS、Linux 三个平台
- 加了负载均衡代理,后面可以挂多台设备,按负载分发任务
- 升级了传输接口,支持 FLAC 等压缩格式,传输体积更小
- 增加了整文件转录的调用库(SDK),自己写程序时,把整段音频丢进去就能拿到结果
模型支持基本继承上游,Paraformer、SenseVoice、Qwen3-ASR 等都能用,另外加了 Mac 上的 MLX 版 Qwen3-ASR。因为它原本就是为语音输入法设计的,接口保留了实时识别的能力,原则上拿它做本地直播实时字幕之类的东西也没问题。
funasr_spk_server:区分说话人
CapsWriter 是纯转录,不区分说话人。语音输入当然够用,但播客、访谈这类场景就完全不够了。当时我没找到开箱即用、效果又好的消费级方案,干脆在 2025 年 7 月和 Claude Code 一起,从零写了 funasr_spk_server,后来 Codex 等也陆续参与了迭代。
它基于 FunASR,把说话人识别封装成一个拿来就能调用的服务:
- 自动合并同一说话人的连续发言
- 相同文件直接返回缓存结果
- 支持 JSON 和 SRT 字幕两种输出
在 M1 Max 64G 上用 Mac 自带的 GPU 加速(MPS),可以开 3 个并发,大概 10 倍实时。我需要区分说话人的转录基本都跑在它上面。
后来 Qwen3-ASR 出来了,今年 5 月我又给它加了 Qwen3 引擎,追求准确率时用。这个引擎最好配英伟达显卡,我放在一台 RTX 3060 的机器上,需要时再开机。
VideoTranscriptAPI:应用层
VideoTranscriptAPI 负责把这些东西串起来:从各平台下载音视频,需要区分说话人就走 funasr_spk_server,不需要就走 CapsWriter,再做上下文校对、总结和推送。它的玩法在《人间万象》里聊过,这里不展开。
它的代码同样是公开的,感兴趣可以直接让 Agent 去读。
为什么我喜欢写服务端
这两个 ASR 服务我每天都在高频使用,用处也不只是音视频总结这一个场景:微信群聊的语音转文字、实时字幕这些,都可以直接拼在它们上面。
当一个工具具备了基础组件的属性,你只需要持续维护它,下游程序通过接口调用,就能长出很多应用层的东西。这也是我现在越来越喜欢写服务端的原因。
把这些项目开源出来,也是希望能帮大家省掉 ASR 踩坑的这一段,直接去拼接、开发更多有意思的东西。如果你也有一台 24 小时开机的设备,不妨试试。
以上。
本文由飞书录音转文字构思底稿,通过 Claude Code + Opus 5.5 对话完成文章架构设计、事实核查与内容整理。